Tema 3: Traducció de programes
21.1 Operacions lògiques i desplaçaments
Enunciat: Problema 12.1.
a) 0x7654 | 0x3333
Resultat: 0x7777.
b) 0x7654 & 0x3333
Resultat: 0x3210.
c) 0x7654 << 2
Desplaçament lògic a l’esquerra de 2 posicions: els dos bits de més pes es perden i s’afegeixen dos zeros per la dreta.
Resultat: 0xD950.
d) 0x7654 >> 3 (desplaçament lògic)
Desplaçament lògic a la dreta de 3 posicions: els tres bits de menys pes es perden i s’afegeixen tres zeros per l’esquerra.
Resultat: 0x0ECA.
Enunciat: Problema 12.5.
En RV32I no hi ha registres de 64 bits. El valor es reparteix entre dos registres de 32 bits: t2 conté els 32 bits de més pes (bits 63–32) i t1 conté els 32 bits de menys pes (bits 31–0).
a) Desplaçament lògic a l’esquerra d’1 posició
El bit 31 de t1 (part baixa) ha de passar a ser el bit 0 de t2 (part alta). La resta dels bits de cada registre es desplacen normalment.
RV32I
b) Desplaçament lògic a la dreta d’1 posició
El bit 0 de t2 (part alta) ha de passar a ser el bit 31 de t1 (part baixa).
RV32I
c) Desplaçament aritmètic a la dreta d’1 posició
Igual que el desplaçament lògic a la dreta, però la posició vacant de t2 s’omple amb el bit de signe original (bit 31 de t2).
RV32I
La diferència entre els apartats b) i c) és l’última instrucció: srli omple amb 0, srai omple amb el bit de signe.
d) Desplaçament lògic a l’esquerra de \(n\) posicions (\(n < 32\), \(n\) a t3)
Els bits superiors de t1 que «surten» per la part alta han d’entrar a t2 per la part baixa. Per obtenir-los, cal desplaçar t1 a la dreta 32 - n posicions.
En RV32I, les instruccions de desplaçament usen els 5 bits de menys pes de l’operand de desplaçament (mòdul 32). Això implica que si n = 0, 32 - n = 32 ≡ 0 (mod 32), de manera que srl t5, t1, t4 desplaçaria 0 posicions en lloc de 32, donant un resultat incorrecte.
Versió restringida (\(1 \leq n \leq 31\))
Si es pot garantir que n mai és 0, la solució és directa:
RV32I
Versió genèrica (\(0 \leq n \leq 31\))
Per cobrir el cas n = 0 sense instruccions de salt, es pot evitar el desplaçament de 32 usant dos desplaçaments consecutius d’1 i 31 - n posicions (la suma és sempre 32 - n, i cap dels dos mai arriba a 32):
RV32I
        li      t4, 31
        sub     t4, t4, t3      # t4 = 31 - n  (rang: 0..31)
        srli    t5, t1, 1       # desplaça 1 posició (segur per a qualsevol n)
        srl     t5, t5, t4      # desplaça 31-n posicions més: total = 32-n
        sll     t2, t2, t3      # desplaça t2 n posicions
        or      t2, t2, t5      # insereix els bits provinents de t1
        sll     t1, t1, t3      # desplaça t1 n posicions
Quan n = 0: t4 = 31, srli t5, t1, 1 desplaça 1 posició i srl t5, t5, 31 desplaça 31 posicions més; total = 32 posicions, resultat correcte (t5 = 0). Quan n > 0: la suma dels dos desplaçaments és 1 + (31 - n) = 32 - n, com cal.
e) Desplaçament lògic a la dreta de \(n\) posicions (\(n < 32\), \(n\) a t3)
Simètric a l’apartat d): els bits inferiors de t2 han d’entrar a t1 per la part alta.
Versió restringida (\(1 \leq n \leq 31\))
RV32I
Versió genèrica (\(0 \leq n \leq 31\))
RV32I
        li      t4, 31
        sub     t4, t4, t3      # t4 = 31 - n  (rang: 0..31)
        slli    t5, t2, 1       # desplaça 1 posició (segur per a qualsevol n)
        sll     t5, t5, t4      # desplaça 31-n posicions més: total = 32-n
        srl     t1, t1, t3      # desplaça t1 n posicions
        or      t1, t1, t5      # insereix els bits provinents de t2
srl t2, t2, t3 # desplaça t2 n posicionsEnunciat: Problema 12.9.
Notació: el contingut inicial de t4 és b31 b30 ... b1 b0.
a) Rotació a l’esquerra d’1 posició.
Cal combinar dos desplaçaments amb un or: el desplaçament a l’esquerra d’1 posició mou tots els bits cap a l’esquerra (perd b31 i deixa un 0 al bit 0), i el desplaçament lògic a la dreta de 31 posicions aïlla b31 al bit 0:
RV32I
Contingut final: b30 b29 ... b1 b0 b31.
b) Seguiment del codi.
El bucle s’executa 16 vegades (t1 va de 16 a 0). A cada iteració:
srli t4, t4, 1desplaçat4una posició a la dreta (lògic: entra un0per l’esquerra).add t2, t2, t2sumat2amb si mateix, és a dir, el duplica: equival a desplaçar-lo una posició a l’esquerra (Secció 3.1.4).
Després de les 16 iteracions:
t4= valor inicial desplaçat 16 posicions a la dreta:0 0 ... 0 b31 b30 ... b16(16 zeros seguits dels 16 bits de més pes).t2= valor inicial desplaçat 16 posicions a l’esquerra:b15 b14 ... b0 0 0 ... 0(els 16 bits de menys pes seguits de 16 zeros).
L’or final combina les dues meitats, que no se superposen:
El codi fa una rotació de 16 posicions: les dues meitats de 16 bits del registre s’intercanvien. Amb una rotació de 16 posicions sobre 32 bits, girar a l’esquerra o a la dreta dona el mateix resultat.
21.2 Sentències condicionals i bucles
switch
Enunciat: Problema 12.12.
C
op a t0, a a t1, b a t2, res a t3.
Implementació 1: cadena d’if-then-else
RV32I
        li      t4, 0
        beq     t0, t4, cas0
        li      t4, 1
        beq     t0, t4, cas1
        li      t4, 2
        beq     t0, t4, cas2
        li      t4, 3
        beq     t0, t4, cas3
        mv      t3, zero            # default: res = 0
        j       fiswitch
cas0:   add     t3, t1, t2          # res = a + b
        j       fiswitch
cas1:   sub     t3, t1, t2          # res = a - b
        j       fiswitch
cas2:   and     t3, t1, t2          # res = a & b
        j       fiswitch
cas3:   or      t3, t1, t2          # res = a | b
fiswitch:
Implementació 2: taula de salts (jump table)
Les constants 0–3 formen un rang dens, cosa que fa la taula de salts eficient.
RV32I
.data
switch_vec:
        .word   cas0
        .word   cas1
        .word   cas2
        .word   cas3

.text
        li      t4, 4
        bgeu    t0, t4, defecte     # si op >= 4, salta al default
        la      t4, switch_vec
        slli    t5, t0, 2           # op * 4
        add     t4, t4, t5          # @switch_vec[op]
        lw      t5, 0(t4)           # llegeix l'adreça del cas
        jr      t5                  # salta al cas corresponent
cas0:   add     t3, t1, t2          # res = a + b
        j       fiswitch
cas1:   sub     t3, t1, t2          # res = a - b
        j       fiswitch
cas2:   and     t3, t1, t2          # res = a & b
        j       fiswitch
cas3:   or      t3, t1, t2          # res = a | b
        j       fiswitch
defecte:
        mv      t3, zero            # res = 0
fiswitch:
Quan és preferible cada enfocament?
La cadena d’if-then-else és preferible quan el nombre de casos és petit (fins a 3–4) o quan les constants no formen un rang dens (per exemple, case 0, case 100, case 1000). La taula de salts és preferible quan les constants formen un rang dens i el nombre de casos és gran: l’accés és \(\mathcal{O}(1)\) independentment del nombre de casos, mentre que la cadena té cost \(\mathcal{O}(n)\) en el pitjor cas.
for simple
Enunciat: Problema 12.13.
a) Traducció a assemblador RISC-V
C
RV32I
b) Nombre total d’instruccions executades
Inicialització (3 instruccions): li t0, li t1, li t2.
Per a cada iteració \(i = 0, 1, \ldots, 9\) (10 iteracions, el salt no es pren): li t3 + bge + add + addi + j = 5 instruccions.
Darrera comprovació (\(i = 10\), el salt es pren): li t3 + bge = 2 instruccions.
Total: \(3 + 10 \times 5 + 2 = \mathbf{55}\) instruccions.
c) Temps d’execució si hi hagués 10 instruccions, CPI = 2, freqüència = 2 GHz
Segons l’Equació 6.3, amb el període de rellotge expressat com a \(1/f_{clock}\):
\[t_{exe} = \frac{n_{ins} \times \text{CPI}}{f_{clock}} = \frac{10 \times 2}{2 \times 10^9} = 10^{-8}\ \text{s} = 10\ \text{ns}\]
d) CPI si el programa, amb les 10 instruccions de l’apartat c), triga \(5 \times 10^{-9}\) s a 2 GHz
\[\text{CPI} = \frac{t_{exe} \times f_{clock}}{n_{ins}} = \frac{5 \times 10^{-9} \times 2 \times 10^9}{10} = \frac{10}{10} = 1\]
És a dir, el programa fa 10 cicles per a 10 instruccions.
Enunciat: Problema 12.17.
Model de costos: memòria = 4 cicles; salt pres = 2 cicles; salt no pres = 1 cicle; resta = 1 cicle. Les pseudoinstruccions es compten per les instruccions en què s’expandeixen: la en són dues, auipc + addi (RISC-V 2.17), i li t3, N, una, perquè se suposa que \(N\) cap en 12 bits (RISC-V 2.16).
Per a cada versió s’analitzen les instruccions executades per iteració i el temps total per a \(N\) iteracions. Les instruccions fora del bucle (inicialització) es compten una sola vegada.
a)
Instruccions fora del bucle: li t0 + li t1 + li t2 = 3 cicles.
Per iteració (\(N\) vegades, salt j pres): li t3 (1) + bge no pres (1) + la t4 (2) + add t4 (1) + lw t4 (4) + add t0 (1) + addi t2 (1) + addi t1 (1) + j pres (2) = 14 cicles.
Última comprovació (\(i = N\)): li t3 (1) + bge pres (2) = 3 cicles.
Total: \(3 + 14N + 3 = 14N + 6\) cicles.
b)
Instruccions fora del bucle: li t0 + li t1 = 2 cicles.
Per iteració: li t3 (1) + bge no pres (1) + la t3 (2) + slli t2 (1) + add t2 (1) + lw t2 (4) + add t0 (1) + addi t1 (1) + j pres (2) = 14 cicles.
Última comprovació: li t3 (1) + bge pres (2) = 3 cicles.
Total: \(2 + 14N + 3 = 14N + 5\) cicles.
c)
Instruccions fora del bucle: li t0 + li t1 = 2 cicles.
Per iteració (condició al final; última iteració: salt no pres): la t3 (2) + slli t2 (1) + add t2 (1) + lw t2 (4) + add t0 (1) + addi t1 (1) + li t3 (1) + blt pres (2) = 13 cicles per a les \(N-1\) primeres iteracions.
Última iteració: blt no pres (1) → cost = \(13 - 2 + 1 = 12\) cicles.
Total: \(2 + 13(N-1) + 12 = 13N + 1\) cicles.
d)
Instruccions fora del bucle: li t0 + li t1 = 2 cicles.
Per iteració (condició al final, comptador decreixent; salt bge pres \(N-1\) vegades): la t3 (2) + slli t2 (1) + add t2 (1) + lw t2 (4) + add t0 (1) + addi t1 (1) + bge pres (2) = 12 cicles per a les \(N-1\) primeres iteracions.
Última iteració: bge no pres (1) → cost = \(12 - 2 + 1 = 11\) cicles.
Total: \(2 + 12(N-1) + 11 = 12N + 1\) cicles.
e)
Instruccions fora del bucle: li t0 (1) + li t1 (1) + la t2 (2) = 4 cicles.
Per iteració (condició al final; salt bne pres \(N-1\) vegades): lw t3 (4) + add t0 (1) + addi t2 (1) + addi t1 (1) + bne pres (2) = 9 cicles per a les \(N-1\) primeres iteracions.
Última iteració: bne no pres (1) → cost = \(9 - 2 + 1 = 8\) cicles.
Total: \(4 + 9(N-1) + 8 = 9N + 3\) cicles.
f) Nova versió que millora l’apartat e)
L’apartat e) ja avalua la condició al final i fa accés seqüencial amb un punter, però encara manté el comptador t1 per detectar el final del bucle. La millora que fa el Codi 21.1 és eliminar la variable d’inducció, comparant directament el punter amb una sentinella que marca el final del vector:
Instruccions fora del bucle: li t0 (1) + la t2 (2) + li t1 (1) + slli (1) + add (1) = 6 cicles.
Per iteració: lw (4) + add (1) + addi (1) + bltu pres (2) = 8 cicles per a les \(N-1\) primeres.
Última iteració: bltu no pres (1) → 7 cicles.
Total: \(6 + 8(N-1) + 7 = 8N + 5\) cicles.
Respecte a l’apartat e) (\(9N + 3\)), s’estalvia 1 cicle per iteració a cost de 2 instruccions d’inicialització addicionals (+2 cicles). Totes dues versions costen el mateix per a \(N = 2\); a partir de \(N = 3\), la versió f) és millor.
21.3 Subrutines: introducció
Enunciat: Problema 12.21.
Codi en C:
Traducció a assemblador RISC-V:
La funció és uninivell (no fa cap crida a una altra subrutina), per tant, no cal desar ra ni cap registre segur.
Els paràmetres a i b arriben per a0 i a1. El resultat es retorna per a0.
RV32I
Anàlisi: si a < b el salt es pren i es retorna a0 sense modificar (el mínim és a). Si a >= b el salt no es pren, a0 s’actualitza amb b i es retorna (el mínim és b). El cas a == b queda correctament cobert: blt no salta amb igualtat, de manera que s’executa mv a0, a1, però com que a == b el resultat és el mateix.
main i examen
Enunciat: Problema 12.23.
C
vect1 i vect2 són variables globals.
a) Traducció de main
main és multinivell (crida examen), per tant, ha de desar ra.
RV32I
b) Traducció d’examen
examen és uninivell: no fa cap crida i no usa cap registre segur. La variable local i s’assigna a t0 (temporal).
RV32I
examen:
        # a0 = @vi,  a1 = @vo
        li      t0, 0               # i = 0
bucle:
        add     t1, a0, t0          # @vi[i]
        lb      t2, 0(t1)           # t2 = vi[i]
        beqz    t2, fivi            # salta si vi[i] == '\0'

        li      t3, ' '
        beq     t2, t3, espai       # salta si vi[i] == ' '

        addi    t2, t2, -32         # vo[i] = vi[i] - 32  (passa a majúscula)
        j       escriu
espai:                              # vo[i] = vi[i]  (copia l'espai)
escriu:
        add     t3, a1, t0          # @vo[i]
        sb      t2, 0(t3)           # vo[i] = t2
        addi    t0, t0, 1           # i++
        j       bucle
fivi:
        add     t3, a1, t0          # @vo[i]
        sb      zero, 0(t3)         # vo[i] = '\0'
retAnàlisi: la funció recorre vi byte a byte fins al '\0'. Per a cada caràcter que no és un espai, en resta 32 (que és la diferència entre els codis ASCII de les minúscules i les majúscules corresponents, 'a' - 'A' = 32) i el desa a vo, convertint-lo a majúscula. Els espais es copien sense modificar. El '\0' final s’escriu explícitament a vo després del bucle.
jalr
Enunciat: Problema 12.30.
Primer cal fixar les adreces de les instruccions. La pseudoinstrucció la s’expandeix en dues instruccions reals, auipc + addi. Suposant que el fragment comença a l’adreça \(A\):
| Adreça | Instrucció | Observacions |
|---|---|---|
| \(A\) | auipc ra, ... |
expansió de la ra, etiq |
| \(A + 4\) | addi ra, ra, ... |
expansió de la ra, etiq |
| \(A + 8\) | addi ra, ra, -4 |
|
| \(A + 12\) | jalr ra, 0(ra) |
etiq |
Per tant, etiq \(= A + 12\).
Per fer el seguiment cal recordar la semàntica de jalr rd, offset(rs1): l’adreça de destinació es calcula amb el valor actual de rs1, i després s’escriu rd ← PC + 4. Quan rd i rs1 són el mateix registre (com aquí, ra), la lectura es fa abans de l’escriptura.
Seguiment pas a pas:
la ra, etiq→ra\(= A + 12\).addi ra, ra, -4→ra\(= A + 8\).- 1a execució de
jalr(PC \(= A + 12\)): destinació \(=\)ra\(+\ 0 = A + 8\);ra← PC \(+\ 4 = A + 16\). Salta a \(A + 8\), la instruccióaddi ra, ra, -4. addi ra, ra, -4→ra\(= A + 16 - 4 = A + 12\). El flux continua seqüencialment cap a \(A + 12\).- 2a execució de
jalr(PC \(= A + 12\)): destinació \(= A + 12\) (salta a si mateixa!);ra← \(A + 16\). - 3a execució de
jalr(PC \(= A + 12\)): destinació \(=\)ra\(= A + 16\);ra← \(A + 16\). Salta a \(A + 16\), fora del fragment: l’execució continua amb el codi que segueixi.
Resposta: c) la instrucció jalr s’executa 3 vegades.
El resultat no depèn de quantes instruccions ocupi l’expansió de la: el primer jalr salta a etiq \(- 4\), que és sempre la instrucció addi ra, ra, -4 immediatament anterior.
21.4 Subrutines: context i bloc d’activació
A amb bloc d’activació
Enunciat: Problema 12.33.
C
a) Traducció de x = A(x, z, w)
Aquesta sentència forma part de codi que crida A. Els paràmetres s’han de preparar abans de la crida: i (char) per a0, k (int) per a1, v (char *) per a2.
RV32I
b) Bloc d’activació d’A (Figura 21.1)
Variables locals: r[10] (10 chars × 1 byte = 10 bytes) + c (escalar, s’assigna a registre). Per tant, el BA conté únicament r.
Mida del BA: 10 bytes, arrodonit a múltiple de 4 → 12 bytes.
A és uninivell (no fa cap crida a cap altra subrutina): no cal desar ra.
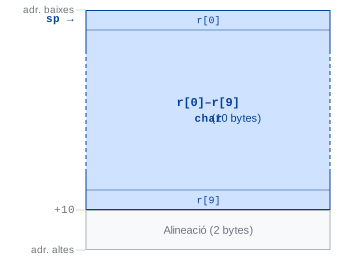
A: el vector r al desplaçament +0 i l’alineació als bytes +10–+11.
c) Traducció d’A
Els paràmetres arriben per a0 (i, char), a1 (k, int), a2 (v, char *). El resultat es retorna per a0.
La variable c s’assigna a t0 (escalar, uninivell). El vector r va al BA.
21.5 Compilació, assemblatge, enllaçament i càrrega
la i rang del desplaçament
Enunciat: Problema 12.36.
Quines instruccions? la rd, symbol s’expandeix en auipc + addi (RISC-V 2.17):
RV32I
on offset = @symbol − PC és la distància entre la instrucció auipc i el símbol.
Per què en calen dues? Un desplaçament de 32 bits no cap en cap immediat d’RV32I: el més gran és el de 20 bits del format U. Calen dues instruccions per construir els 32 bits: auipc aporta els 20 bits superiors (sumats al PC) i addi els 12 bits inferiors. Com en l’expansió de li amb lui + addi, si el bit 11 de lo_12 val 1 cal incrementar hi_20 en 1 per compensar l’extensió de signe d’addi (el mecanisme detallat és a Problema 11.5).
Limitació del desplaçament: l’expansió codifica un desplaçament de 32 bits amb signe, \([-2^{31}, 2^{31}-1]\), de manera que el símbol ha de ser dins d’un rang de ±2 GiB respecte al PC. En RV32I, on l’espai d’adreces és de 32 bits (4 GiB) i l’aritmètica d’adreces és mòdul \(2^{32}\), aquest rang cobreix a la pràctica tot l’espai d’adreces; en arquitectures de 64 bits, en canvi, és una limitació real que obliga a usar altres mecanismes per a símbols més llunyans.
Enunciat: Problema 12.37.
a) Fases del flux de generació
Les tres fases que intervenen en construir l’executable a partir d’a.c i b.c són:
- Compilació: el compilador tradueix cada fitxer
.ca assemblador (.s). En aquesta fase s’apliquen les regles de l’ABI i es generen les instruccions de l’ISA, però les adreces no es resolen: s’usen etiquetes. - Assemblatge: l’assemblador tradueix cada fitxer
.sa codi màquina (.o). Construeix la taula de símbols locals, expandeix pseudoinstruccions i genera les llistes de reubicació i de referències externes per als símbols no resolts. - Enllaçament: l’enllaçador (linker) combina
a.oib.o, resol els símbols globals i externs (x,f), corregeix les adreces provisionals i genera l’executable.
La càrrega en memòria la fa el sistema operatiu i no forma part del procés de construcció de l’executable en si.
b) Qui resol les referències externes a x i f de b.o?
L’enllaçador, en la fase d’enllaçament. Durant l’assemblatge de b.s, x i f no estan definits en aquest mòdul, de manera que l’assemblador deixa adreces provisionals i les anota a la llista de referències externes. Quan l’enllaçador combina a.o i b.o, cerca x i f a la taula de símbols globals d’a.o (on estan declarats amb .globl) i substitueix les adreces provisionals per les adreces definitives.
c) Efecte de declarar static int x = 42 a a.c
Amb static, x passa a tenir vinculació interna (internal linkage): deixa de ser visible fora del mòdul a.c. L’assemblador no l’inclou a la taula de símbols globals del fitxer objecte a.o. En conseqüència, quan l’enllaçador intenta resoldre la referència externa a x de b.o, no la troba i finalitza amb un error (amb el muntador de GNU, undefined reference to 'x').
d) Per què la t0, x es tradueix amb auipc i no amb lui?
L’expansió en auipc + addi i el rang de ±2 GiB són els de Solució 21.11.
La raó d’usar auipc (relatiu al PC) en lloc de lui (adreça absoluta) és que en un fitxer objecte reubicable les adreces absolutes no es coneixen fins a l’enllaçament. Amb adreces relatives al PC, el desplaçament entre la instrucció i el símbol és constant independentment d’on es carregui el programa en memòria, cosa que simplifica la reubicació.